上海微系统所“聆语”亮相2026浦江创新论坛
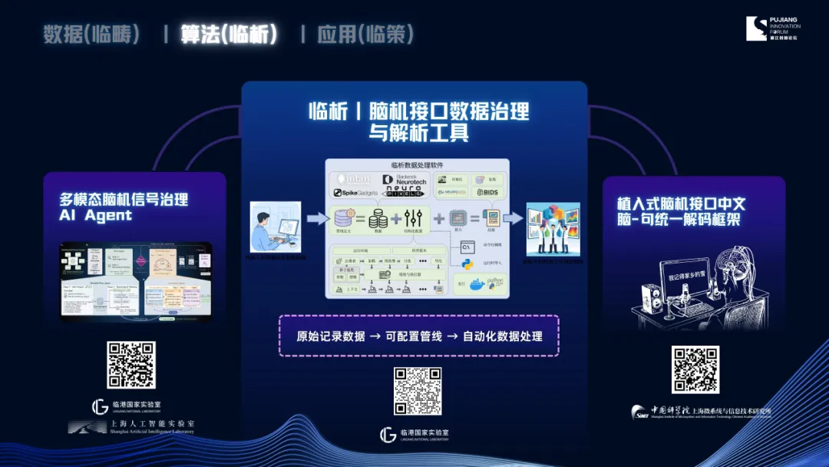
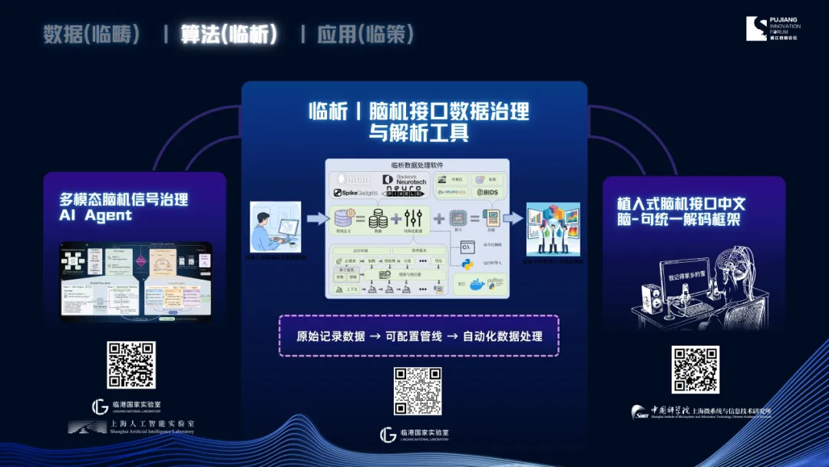
9月11日,第十九届浦江创新论坛成果发布会在上海张江科学会堂举行。作为展示前沿科技成果的重要环节,脑机接口板块率先亮相。由临港国家实验室牵头,中国科学院上海微系统与信息技术研究所、中国科学院脑科学与智能技术卓越创新中心、上海人工智能实验室、清华大学等多家企事业单位共同建设的脑机接口一体化飞轮引擎——“游刃(U-RUN)”首发首秀,覆盖数据、算法、平台及应用等多个关键环节,集中呈现了目前脑机接口领域从基础研究和关键技术突破向系统协同、应用转化加速推进的最新进展。
其中,中国科学院上海微系统与信息技术研究所主导研发的植入式脑机接口中文脑-句统一解码框架“聆语”,作为“游刃”算法层的重要成果之一,在本次论坛正式发布。该成果面向脑机语言解码长期存在的个体依赖和中文语言体系复杂两项关键挑战,探索以人工智能提升脑机语言解码通用性的新技术路径。
据上海微系统所研究员、“聆语”研发负责人李孟介绍,当前植入式脑机接口语言解码普遍存在较强的个体依赖性,需要针对不同用户分别进行数据采集、模型训练和参数适配,长期受制于“一人一模型”的定制化模式,不仅增加了系统部署和使用成本,也限制了脑机语言解码的规模化推广。同时,由于中文音素自由度较大、字符体系复杂,如何准确、高效地还原中文语言内容,始终是制约脑机接口技术从实验室走向实际应用的关键问题。
针对上述问题,“聆语”系统依托临床成熟的sEEG(立体定向脑电图)电极,使用共享音节成分表征降低中文大字符体系带来的解码复杂度,并以AI为突破口,通过面向脑机语言任务深度定制的大语言模型提升解码能力,实现跨任务、跨个体的稳定精准中文解码,探索脑机语言解码由个体化定制向更高通用性和可扩展性方向演进。
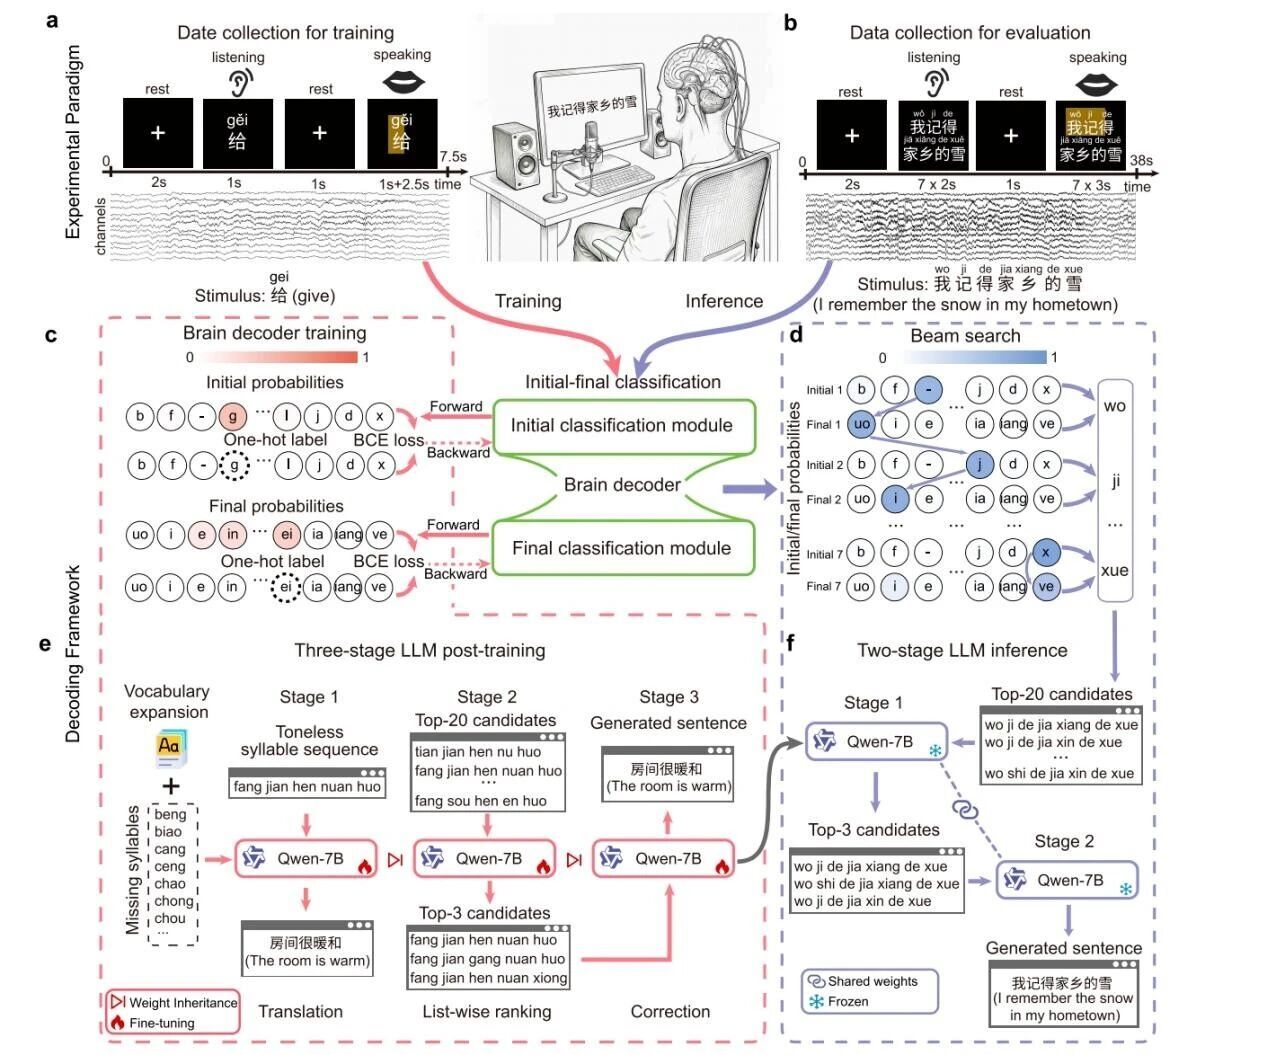
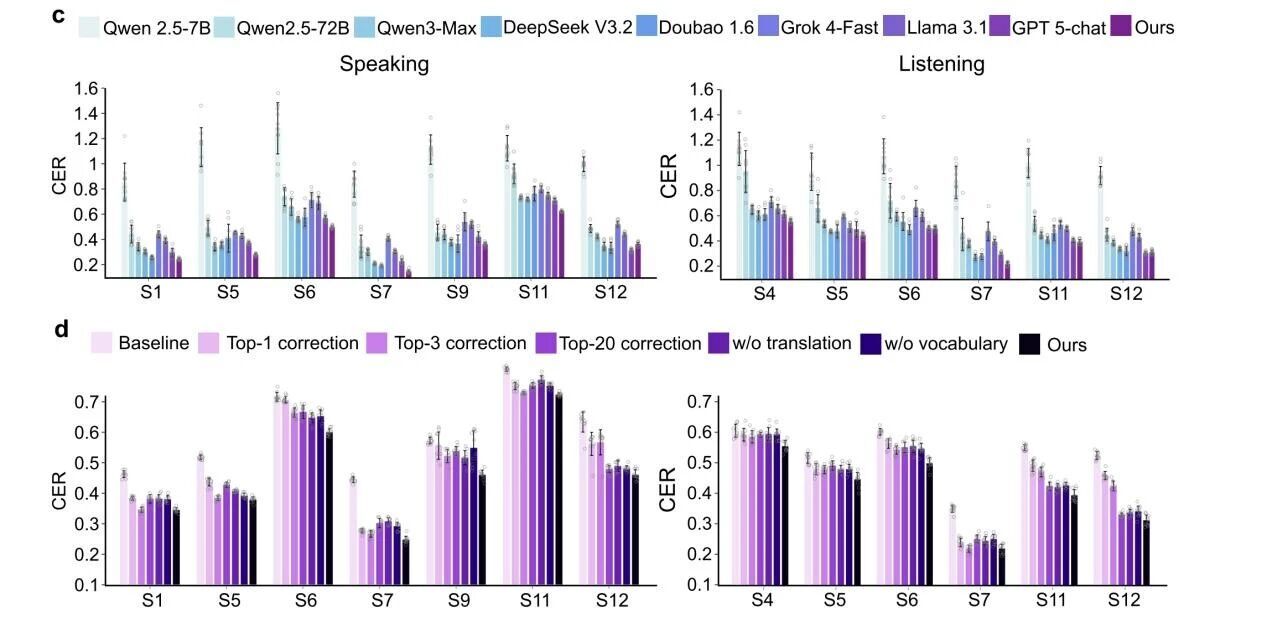
在关键性能方面,“聆语”展现出三方面特点。首先,通过将语言“生成”和“感知”映射为统一的共享音节成分表征,同一框架能够支持“说”与“听”两类语言任务,实现跨任务泛化;其次,在15名受试者中均保持稳定的解码表现,体现出色的跨个体泛化能力,为推动脑机语言解码规模化应用提供支撑;此外,针对脑机中文语言解码任务,团队对70亿参数大语言模型进行了深度定制与优化,使其在该特定任务上的整体性能超过千亿参数规模的通用商业大语言模型。结果表明,在AI深度赋能下,模型能力不再简单受制于参数规模,更关键的是模型与具体脑机任务之间的精准适配。
“此前国内各主要团队大多分头开展研究,但数据与算法只有集聚力量,才能释放最大价值。”李孟表示,此次系列成果集体发布,并非对上海脑机接口最新进展进行简单的“打包”式展示,更意味着上海正式统筹推进脑机接口产业链贯通。“随着相关平台落地搭建,将吸引各方贡献算法、择优迭代,共营共建脑机接口创新生态。”
未来,中国科学院上海微系统与信息技术研究所将继续发挥神经信号解析、人工智能算法与脑机接口研究等方面的技术积累,深化与临港国家实验室、中国科学院脑科学与智能技术卓越创新中心及相关科研、临床和产业机构的协同合作,在开放共建中推动数据、算法与应用持续迭代,加快脑机接口关键技术向实际应用转化。